文本处理技术
Diese Notiz ist noch nicht ins Deutsche übersetzt – Sie lesen das chinesische Original.
文本处理技术
文本分析流程
- 原始数据(Raw data)网页文本 新闻 报告
- 如果是中文需要segmentation分词
- 清洗的操作:清洗内容是无用的标签,特殊符号,停用此,如果是英文法文等需要大写转小写
- 标准化Normalization:主要是Stemming或者Lemmatization
- 特征提取 Feature Extraction:主要是关键词的提取或者是短语挖掘
- 文本表示:text representation,主要是把文本转化成数值的表达形式,相应的模型有词袋模型,tf-idf和word2vec等
- modeling:如果是聊天机器人我们可以基于匹配做一个相似度算法,如果是文本分类我就用分类算法
Stemming VS Lemmatization
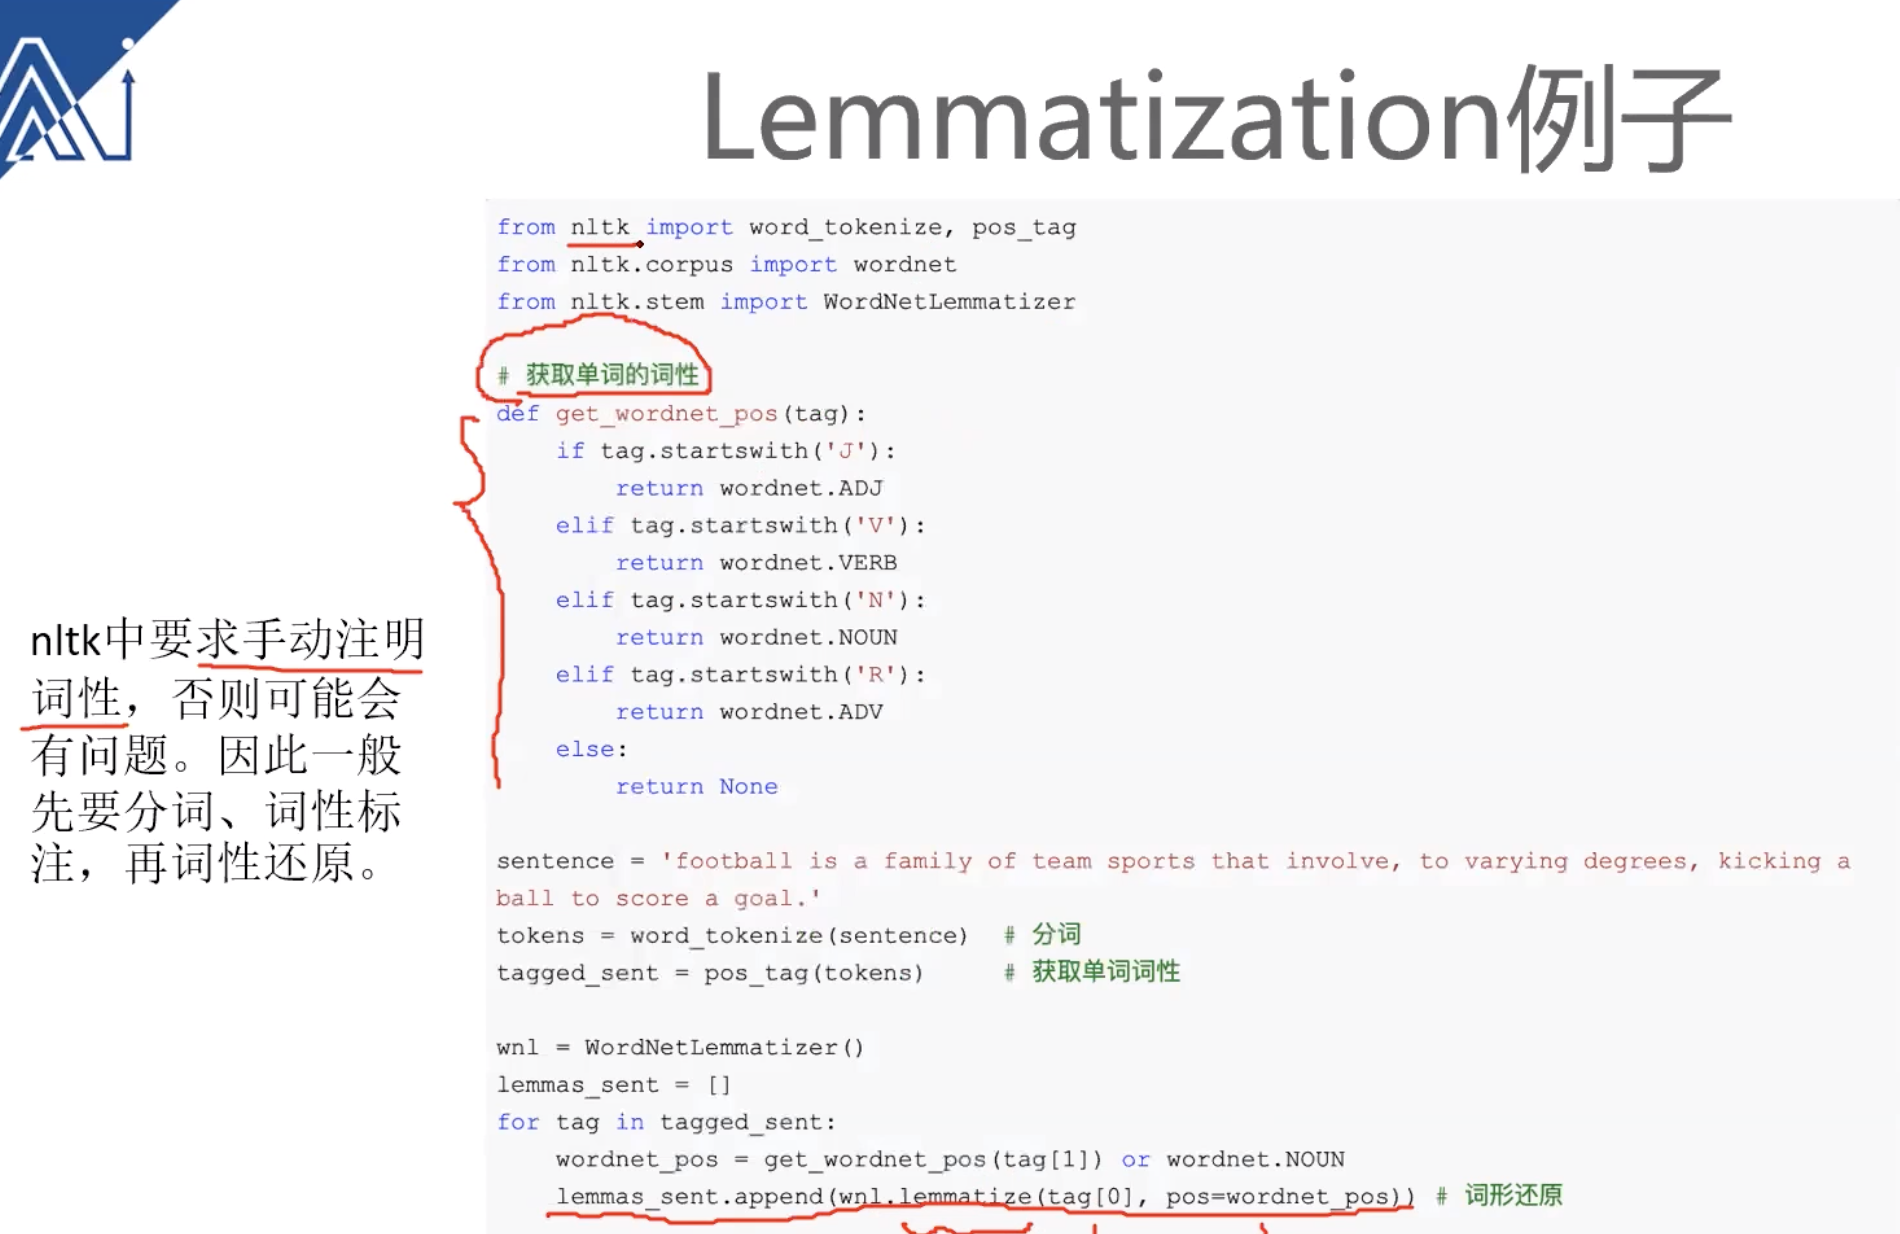
词干提取Stemming 是把一个词转化成词干或者词根的形式,不一定能够完整表达语义主要采用缩减法,比如将cats 转化为cat,将driving转化为driv,这种情况就丢失了一个字母e,相对比较简答
Lemmatization词性还原:把任何形式的语言词汇转化为一般的形式,能够完整的表达语义,主要采用转变的方法,将词转化为其原型,比如将drove 转化为drive,将driving转化为drive,涉及到的技术主要是基于规则,词法,语义,相对来说更加复杂一些。
上面这些任务都是有现成的工具包可以完成,一般来说都是完成的比较好,准确率比较高
词干提取主要是用于信息检索的领域,用于扩展检索,粒度较粗,词形还原主要用于文本挖掘领域,自然语言处理用于粒度较细,更为准确的文本分析和表达,如果是做中文的处理,这两者接触的一般也不会很多。
调用Python库nltk可以直接来做Stemming,有三种方法:porter,lancaster,snowball
三 分词技术
这个技术主要是针对中文而言的,Chinese word segmentation 是将连续的字序列按照一定的规范重新组合成词序列的过程。分词技术的难点在于分词规范不明确,歧义切分,未登录词识别等
分词规范:对于词的抽象定义(词是什么)和和词的具体界定(什么是词)不确定,比如中华人民共和国可以切分成中华/人民/共和国 这三个部分。
歧义气氛:切分歧义是汉语分词的一个大问题,因为歧义字段在汉语文本中大量存在,比如乒乓球拍卖完了,可以是乒乓球/拍卖/完了,也可以是乒乓球拍/卖完了,从语法上来说都是可以的
未登录词识别:未登录词又叫做生词,如果是某个专业领域内肯定会有很多专业词汇,我们用w2v词向量来表达语义就会和我们当前的文本不对等,所以可能很多词汇不存在。
四 分词技术-向前匹配分词算法
向前最大匹配forword-max matching:从前往后看一个句子,寻找词典中存在的词,比如:
我们经常有意见分歧,对应的词典[我们,经常,有,有意见,意见,分歧]
我们设置max_len = 3,这个值一般取词典中最长的词的长度
这种设置方法是以三个为单位(我们经),如果词典中没有(我们经)就把最后一个去掉(我们),如果有了(我们),就看(经常有)后面三个字,以此类推,我们就可以把这个句子切分出来
后向最大匹配backword-max matching:同理,从后看
最大匹配的缺点:
例如:乒乓球拍卖完了。从前往后和从后往前切分出来的结果是不一样的,按照这句话的理解我们应该是说乒乓球拍/卖完了,这种匹配最大缺点就是没有考虑语义的这个层面。他的优点是速度比较块,实现起来也比较简单,但是遇到歧义和未登录词效果不好
五 分词技术-基于语义的分词
例句:我们经常有意见分歧
词典[我们,经常,有,有意见,意见,分歧]
- 输入句子
- 生成所有的分割情况
- 选择其中最好的
如何评判一个句子是好的,我们需要基于语言模型N-gram模型,计算每句话出现的概率p1,p2,p3,具体的实现也会涉及到动态规划算法
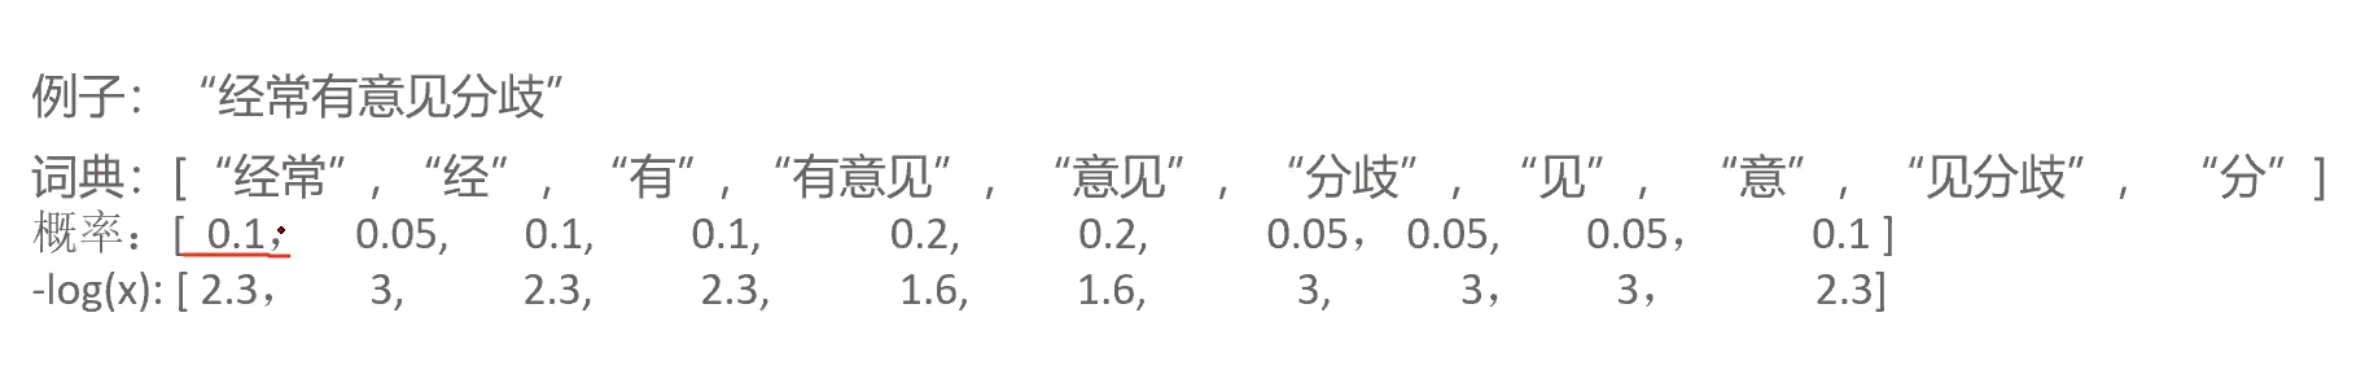
有一个例句,有一个词典,还有每个词在语料库中出现的概率,转化成log的形式是为了防止下溢。
这个是一阶语言模型
防止下溢:p(x1)*p(x2)… ----> -(logP(x1) +logP(x2)+…+logP(xn)),由原来找最大值,变成现在找最小值。
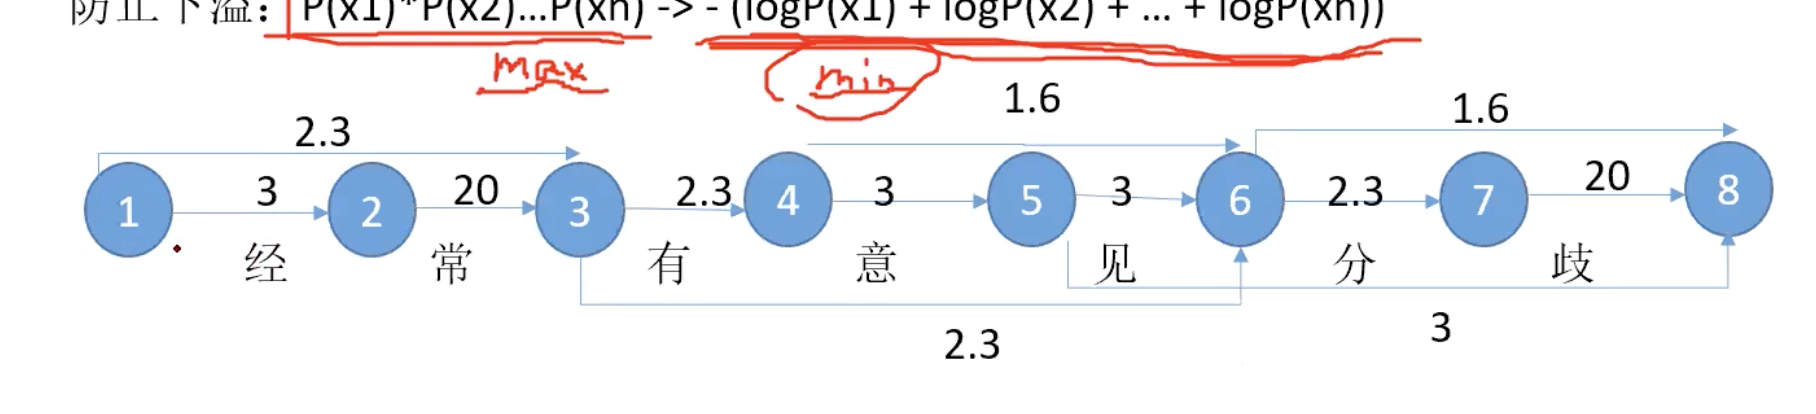
计算最短路径我们使用的是维特比算法,计算f(n)的最小值 f(8)= min[f(7)+20,f(6)+1.6,f(5)+3]
f(1) =0
f(2)=3
f(3)=2.3
f(4)=4.6
f(5)= 7.6
我们最终求的不是最短的距离,而是这个最短的路径经过了哪些的点,所以需要我们维护一个路径的数组
六 分词技术-分词工具
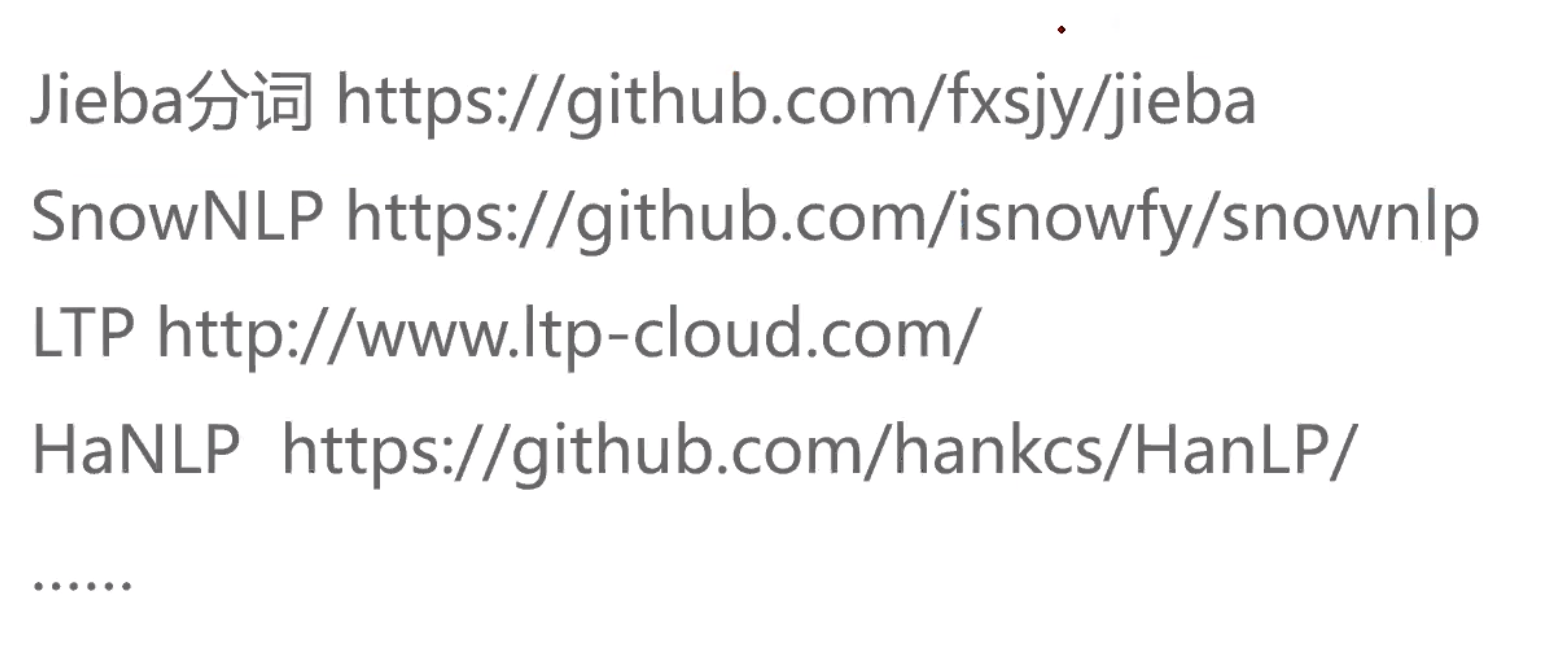
jieba分词,SnowNLP,LTP,HaNLP
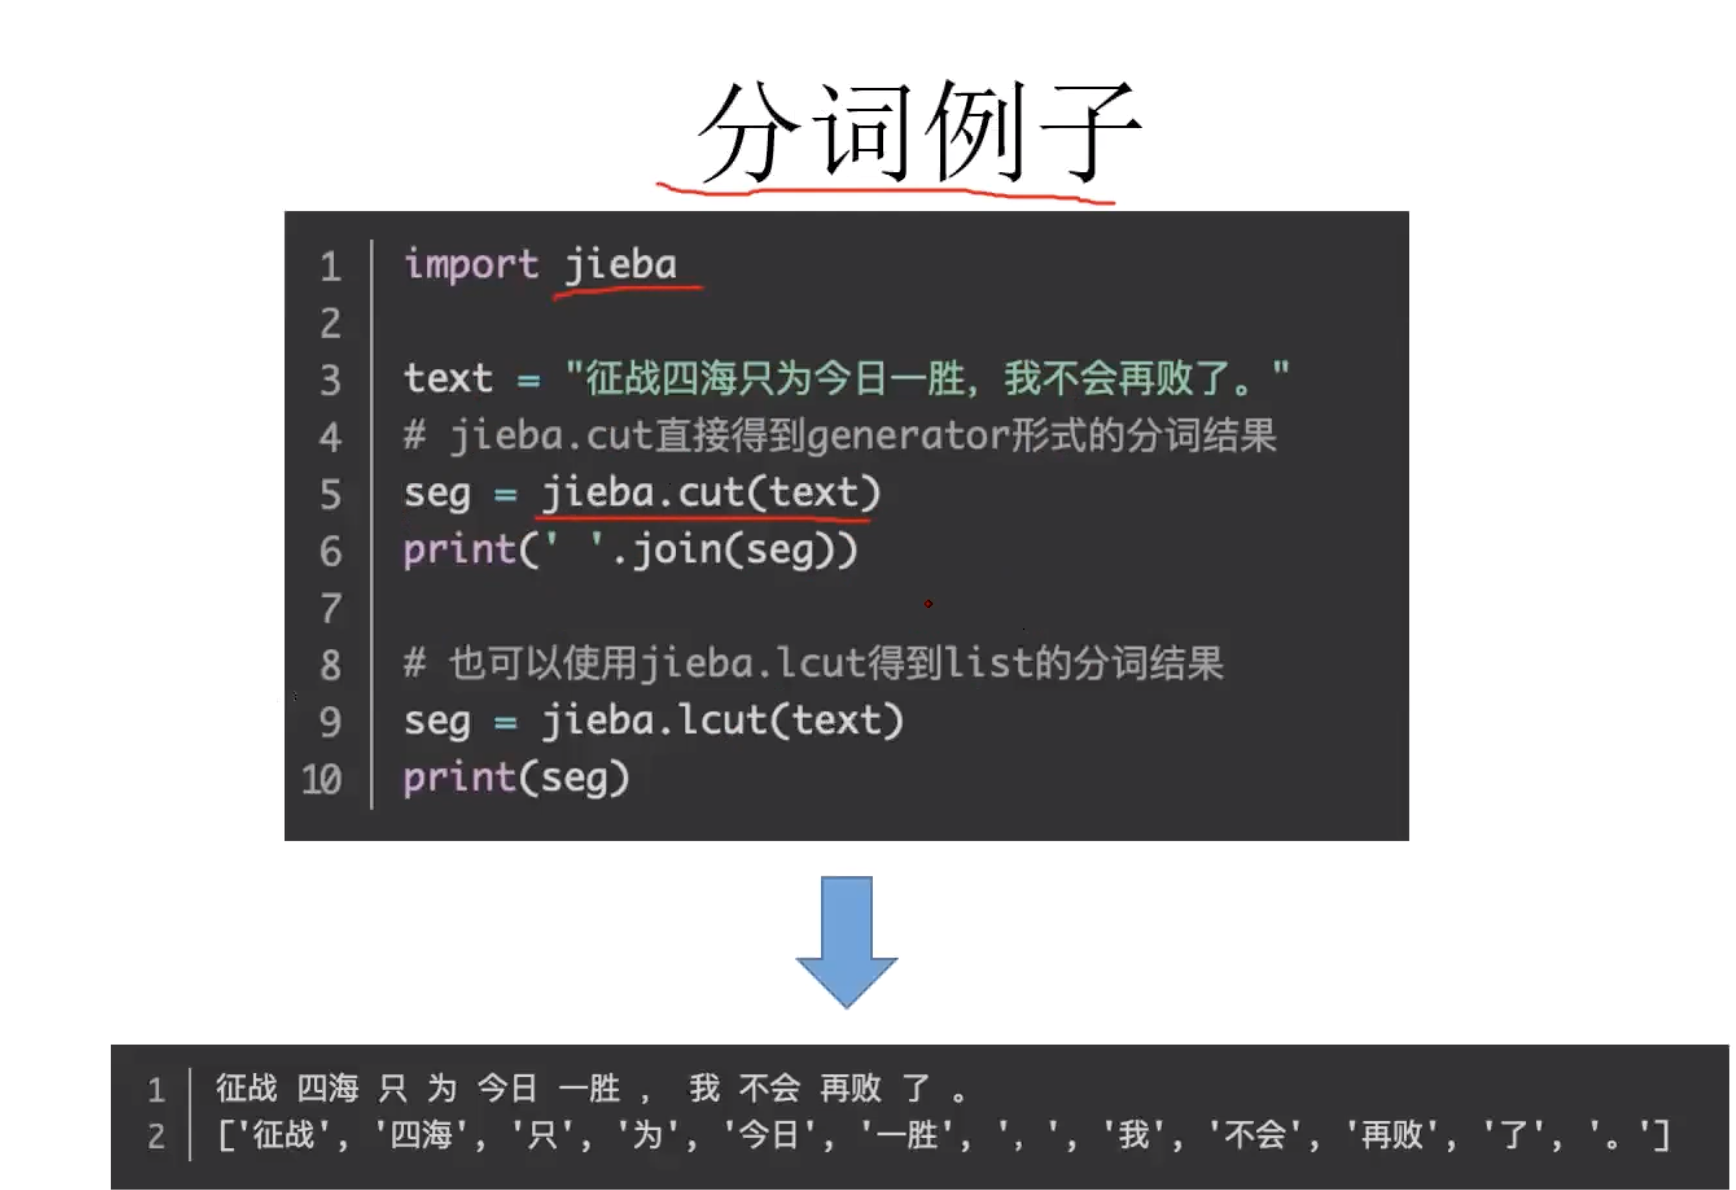
七 分词技术总结
- 基于机械匹配的方式,前向后向或者相结合起来:实现简单复杂度低,但是没有针对语义切分的情况
- 基于概率统计方法,使用语言模型(LM),HMM或者CRF,把分词当作序列模型,然后再来做标注,这样也可以作为一种切分的方式
- 分词可以认为是已经解决的任务,一般都能够达到90%以上的准确率,如果有新的词汇,或者特定词汇,也可以手动添加到词汇表中
我们中文分词一般都是以字为单位,但是如果是古文或者诗词,我们也可以以字为单位
八 需要掌握
可以自行实现基于最大匹配和unigram LM的切词算法
问题:
- CRF的计算复杂度高,准确率也相对比HMM高,但是我们根据不同的饿场景,我们要考虑经济的模型,要在复杂度和准确率之间做一个衡量
- 表情包,针对每一个表情符号,做一个文本替换,我的想法是再加一个表情说明:比如他发了一个‘你好可爱’,如果是表情包就在后面改成“你好可以”1