关键词提取 基于特征统计
This note hasn’t been translated into English yet, so you’re reading the Chinese original.
有的时候一篇文章可能只是需要关注这些关键词就够了,在有些场景下很可能就是某下关键词影响最后的分类结果,所以关键词提取也是一个很重要的预处理层面。我们基于一些特征来看看这个词是不是重要,最常见有一下几种:
- 词频:一个词出现的次数越多,就说明这个词就越重要
- TF-IDF(Term Frequency-Inverse Document Frequency):有很多词出现的次数多,但是是不重要的,比如的,了,the 这些词,所以TF-IDF综合考虑了词在文本中词频以及普遍重要性,直观的说,就是一个词在其他的文本中出现的越少,而在本文中出现的越多,说明他对本文的重要性越强。
- 位置特征,一般来说在摘要,文末,或者一些标题,那么他就会更加重要一些
- 词跨度,值得是一个词在文中首次出现与莫词出现的距离,比如说一本小说的主人公,一般来说他的词跨度是最长的
- 一些词的固有属性:包括一系列特征,词长,词性,对应的语法成分,大小写,词缀等。
基于以上这些特征我们可以把他们转成向量的形式,我们可以用一些机器学习,分类或者SVN,决策树等等。
关键词的提取-基于主题模型
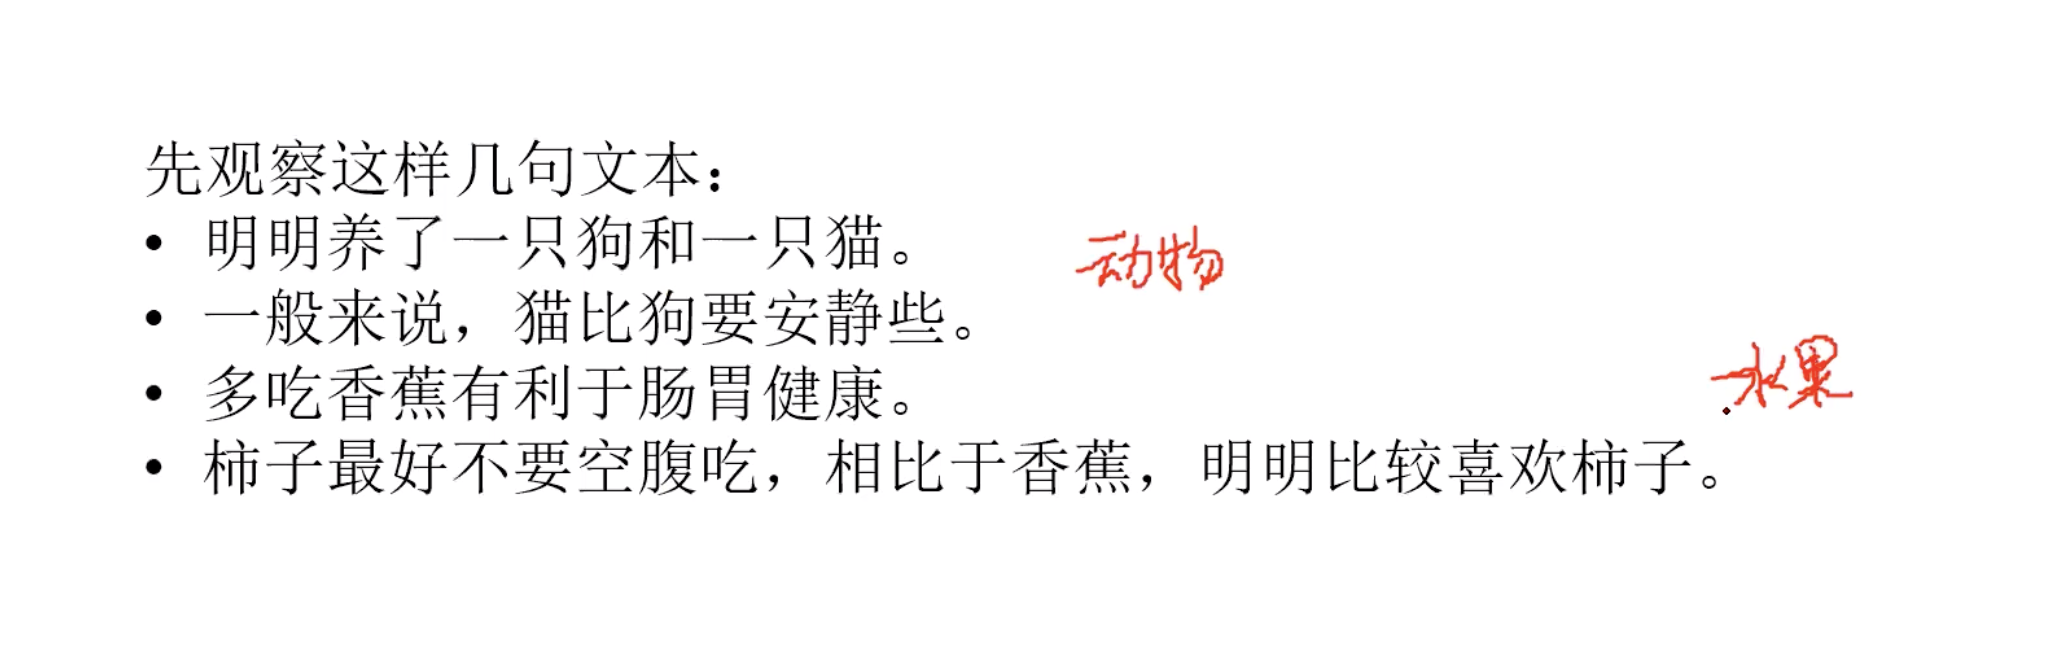
主题模型的核心假设是,存在隐含变量,即文本主题,决定了文本中词汇的出现情况
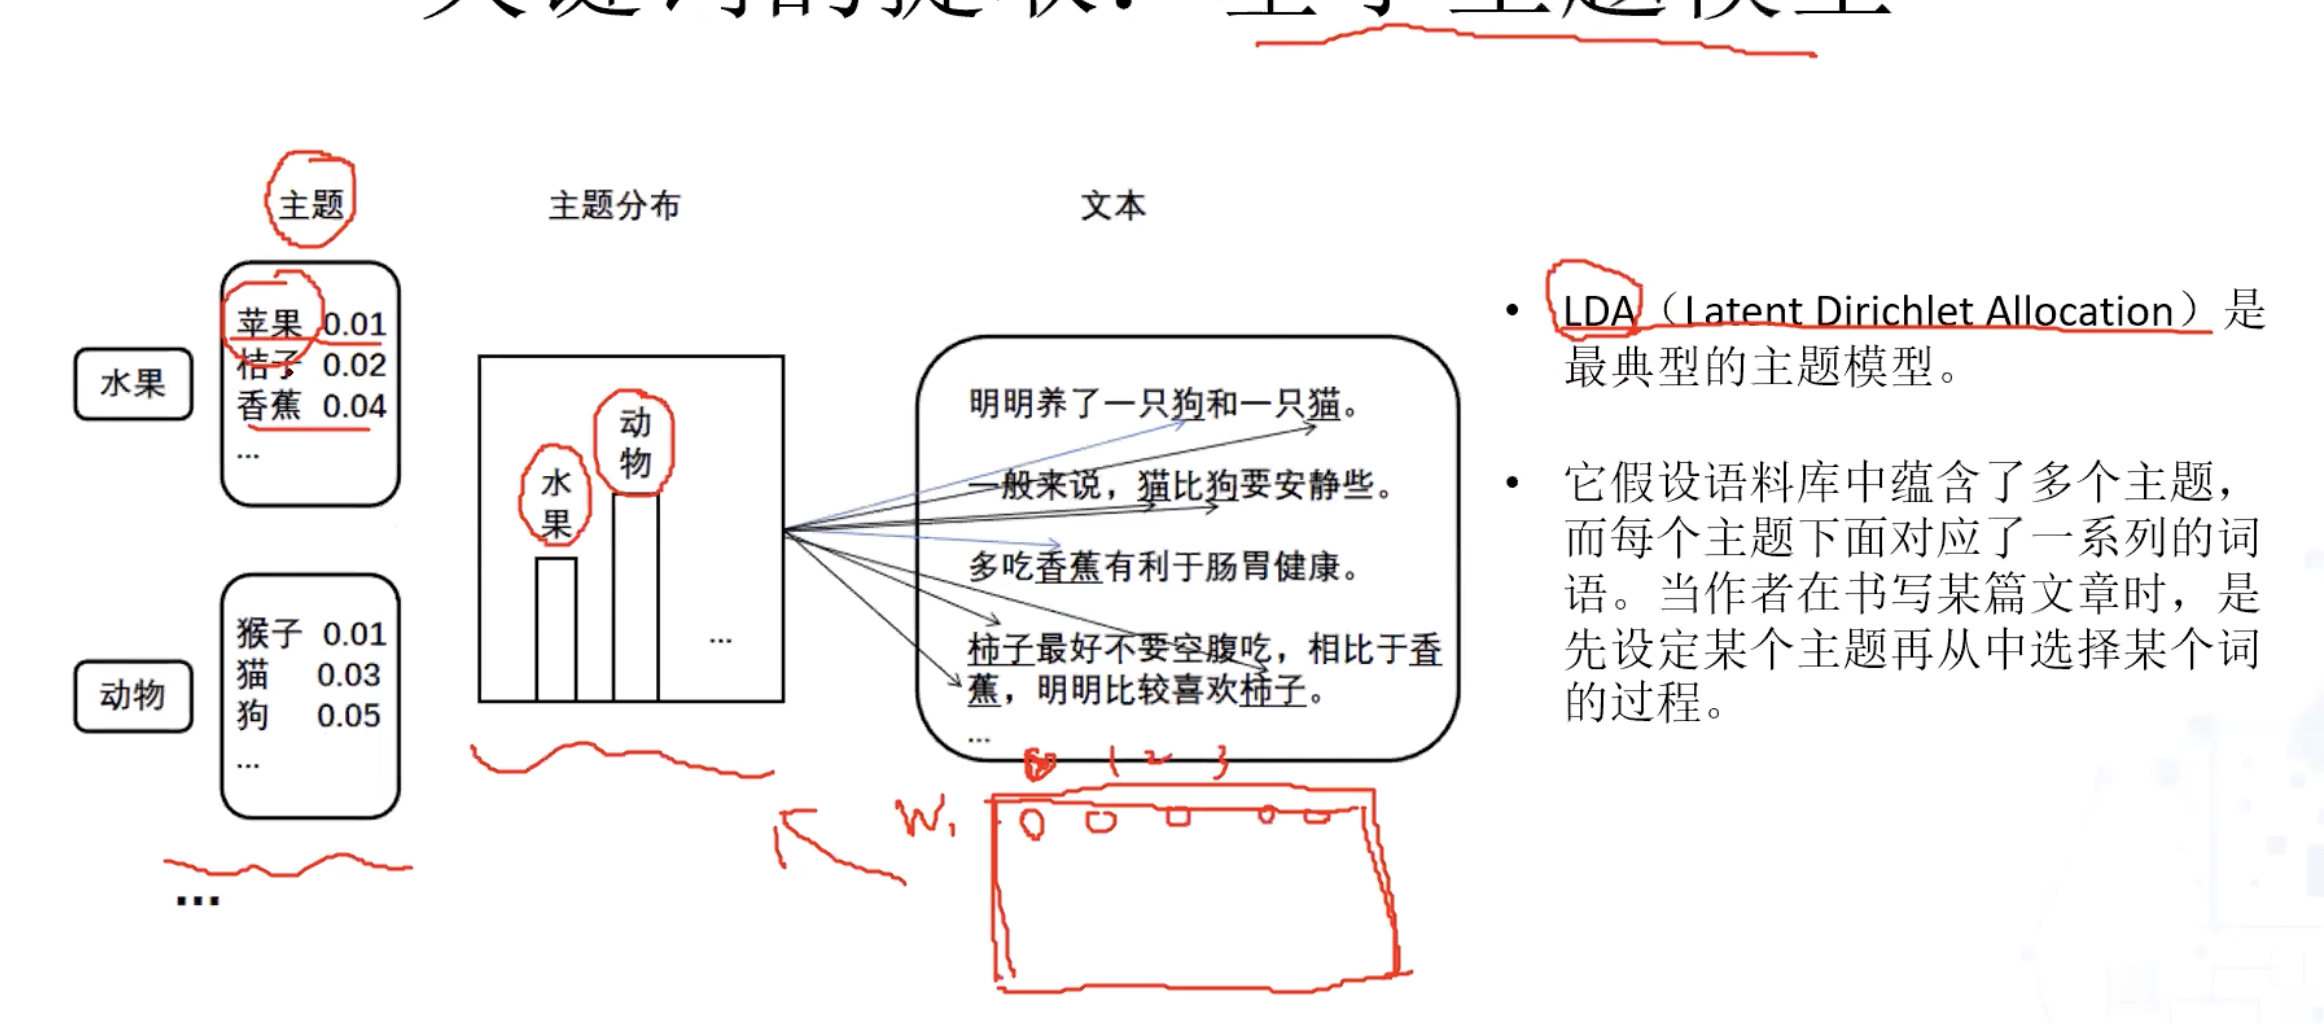
这个模型与数学关系比较紧密,LDA模型需要用比较多的时间来理解。
关键词的提取-基于PageRank
PageRank是谷歌用来做网页排名的算法,在SEO中经常用来评估网页优化的的成效因素之一
它包含两个要点:
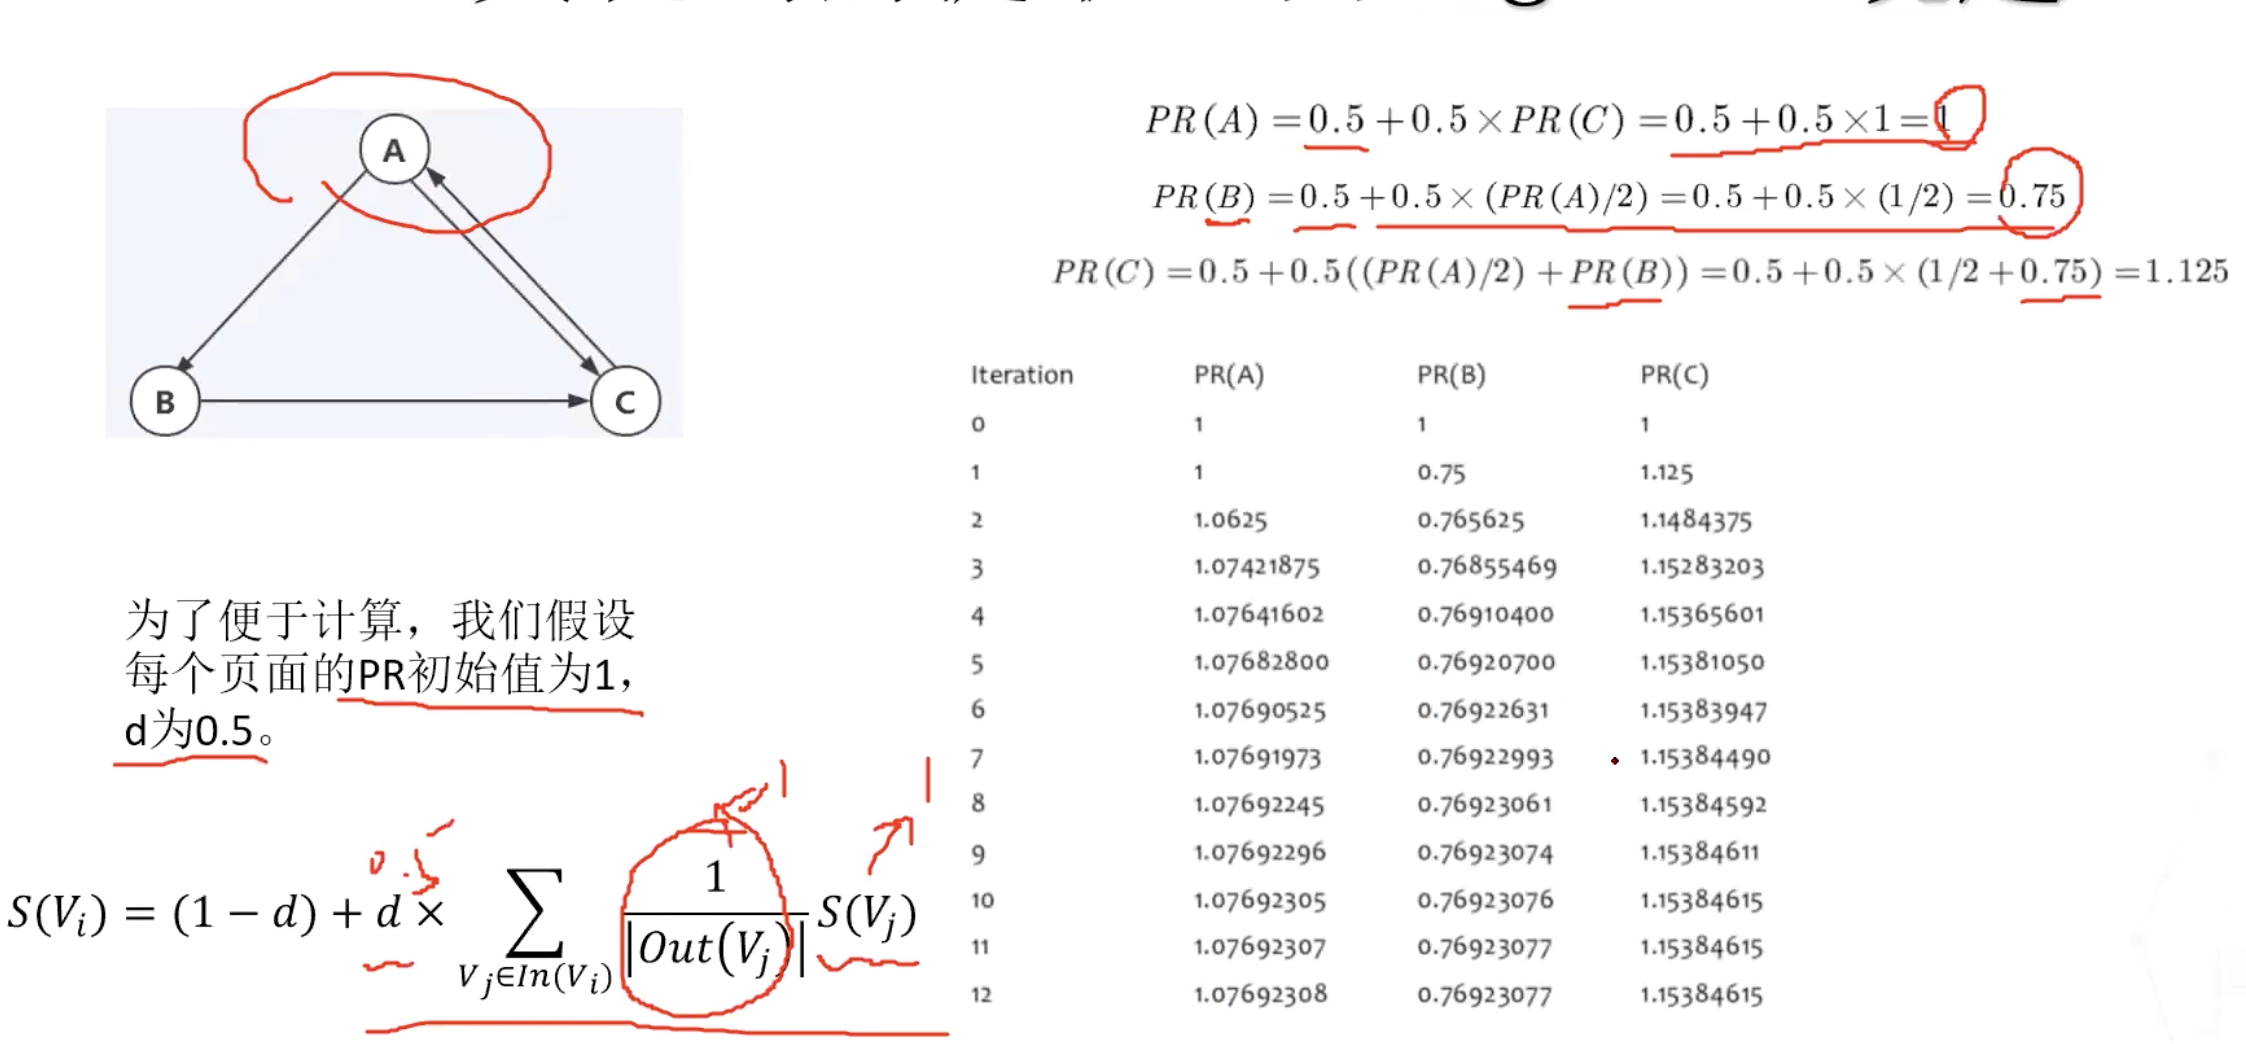
- 一个网页如果其他很多网页链接到,说明这个网页比较重要,也就是PageRank会比较高
- 如果一个PageRank很高的网页链接到其他的网页,那么被链接的网页PageRank值也会相应的提高
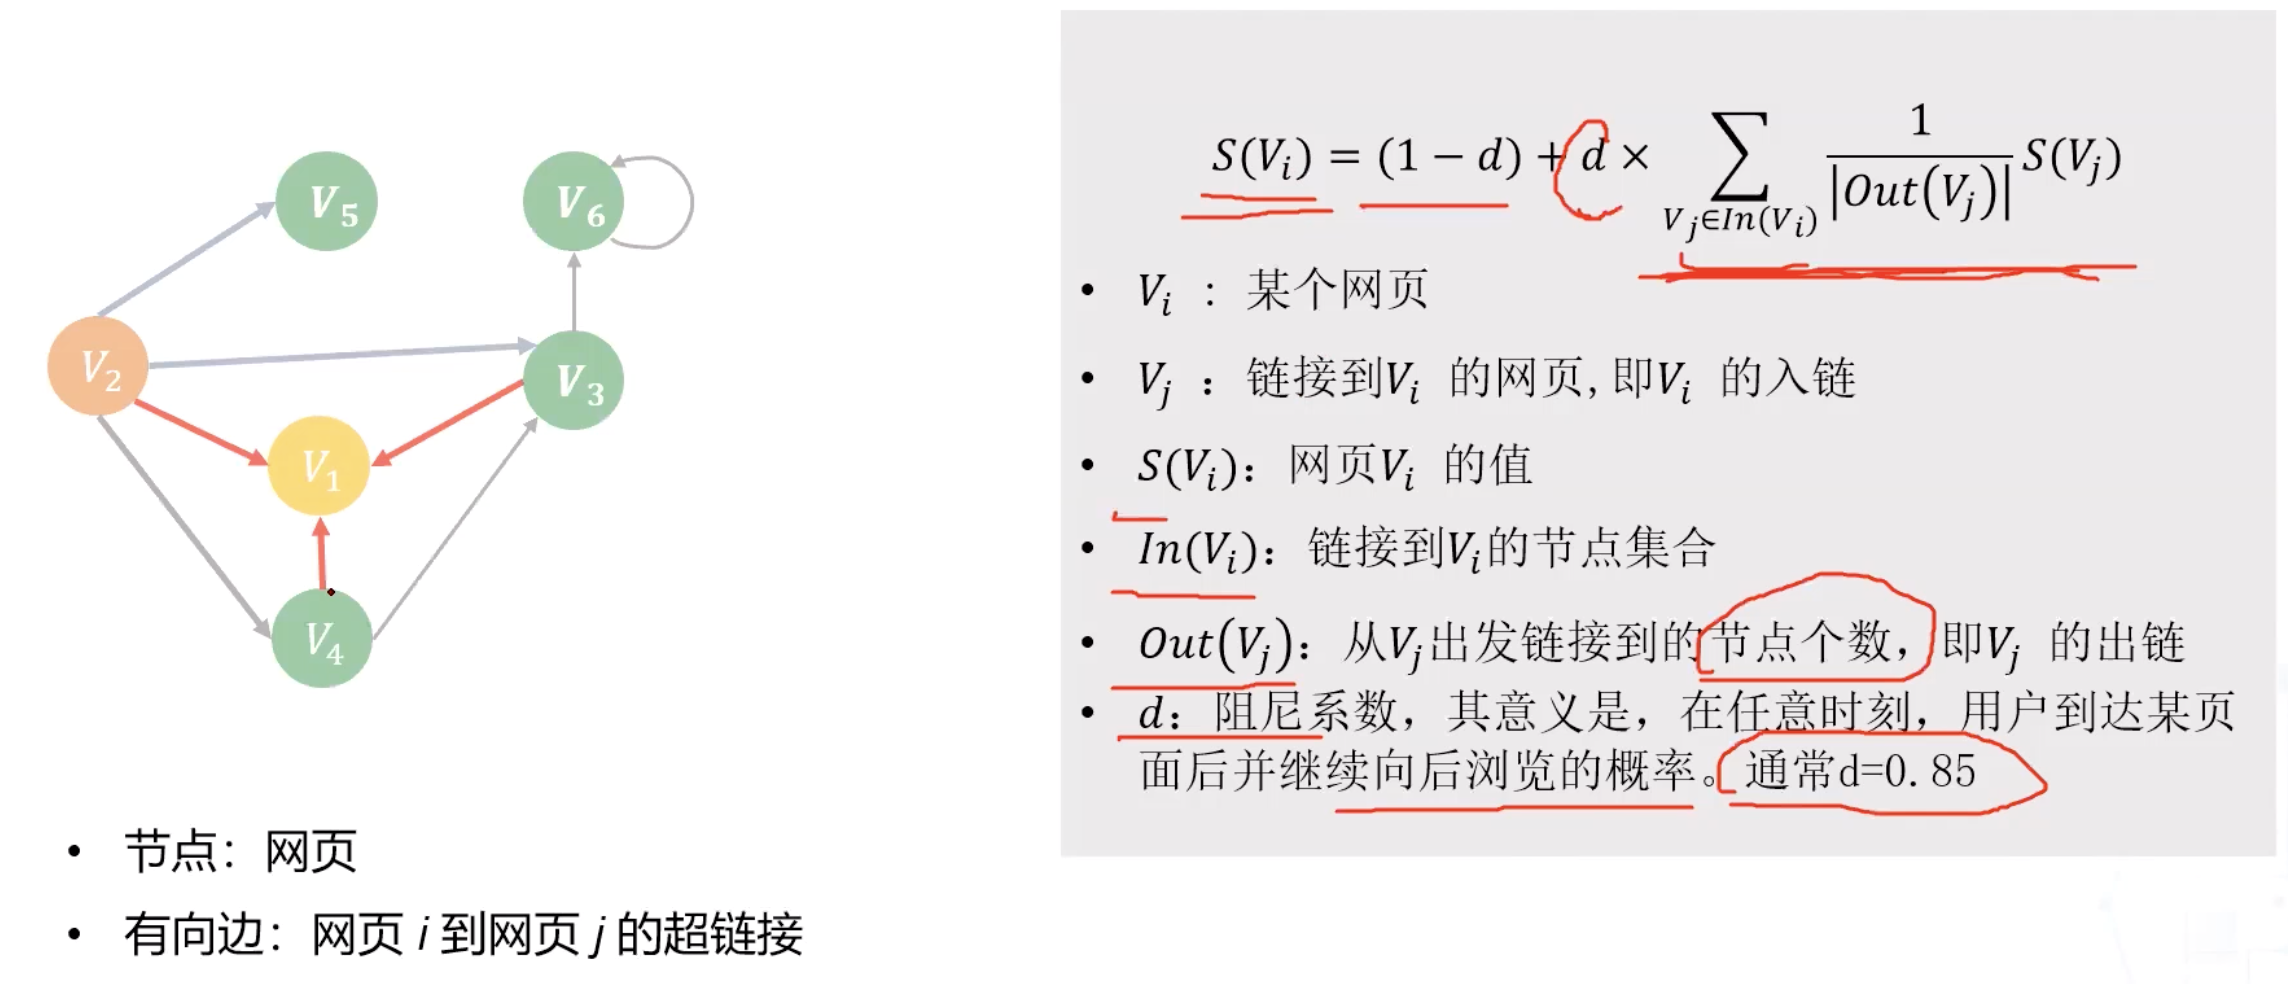
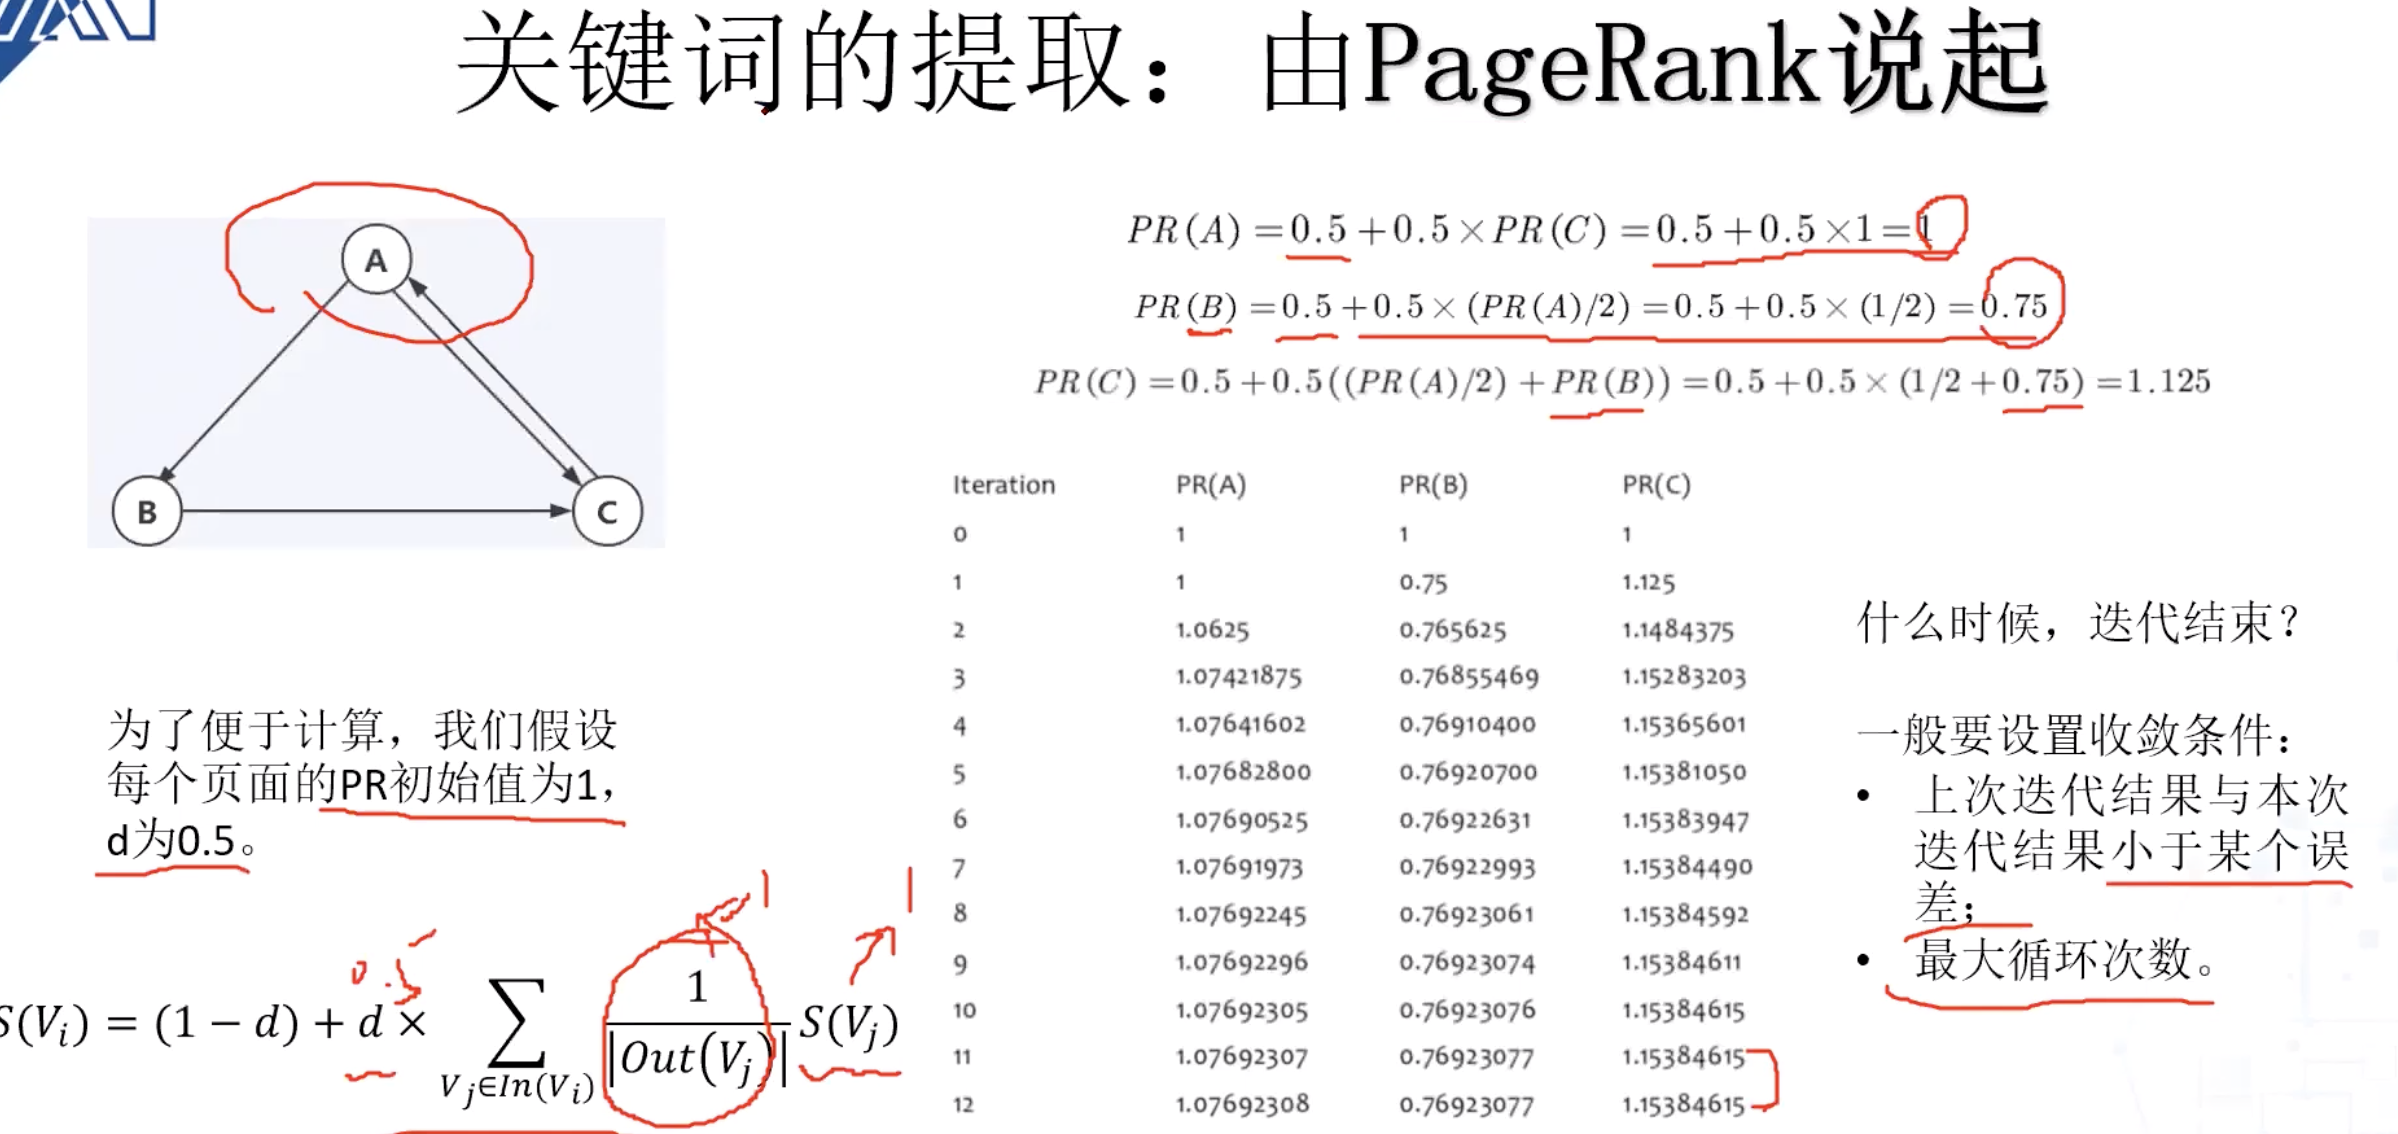
PR值计算实例
TextRank
TextRank在文本上的应用,核心思想如下:
- 如果一个单词出现在很多单词的边上,说明这个单词很重要
- 一个TextRank值很高的单词边上的单词,TextRank值会相应因此而很高
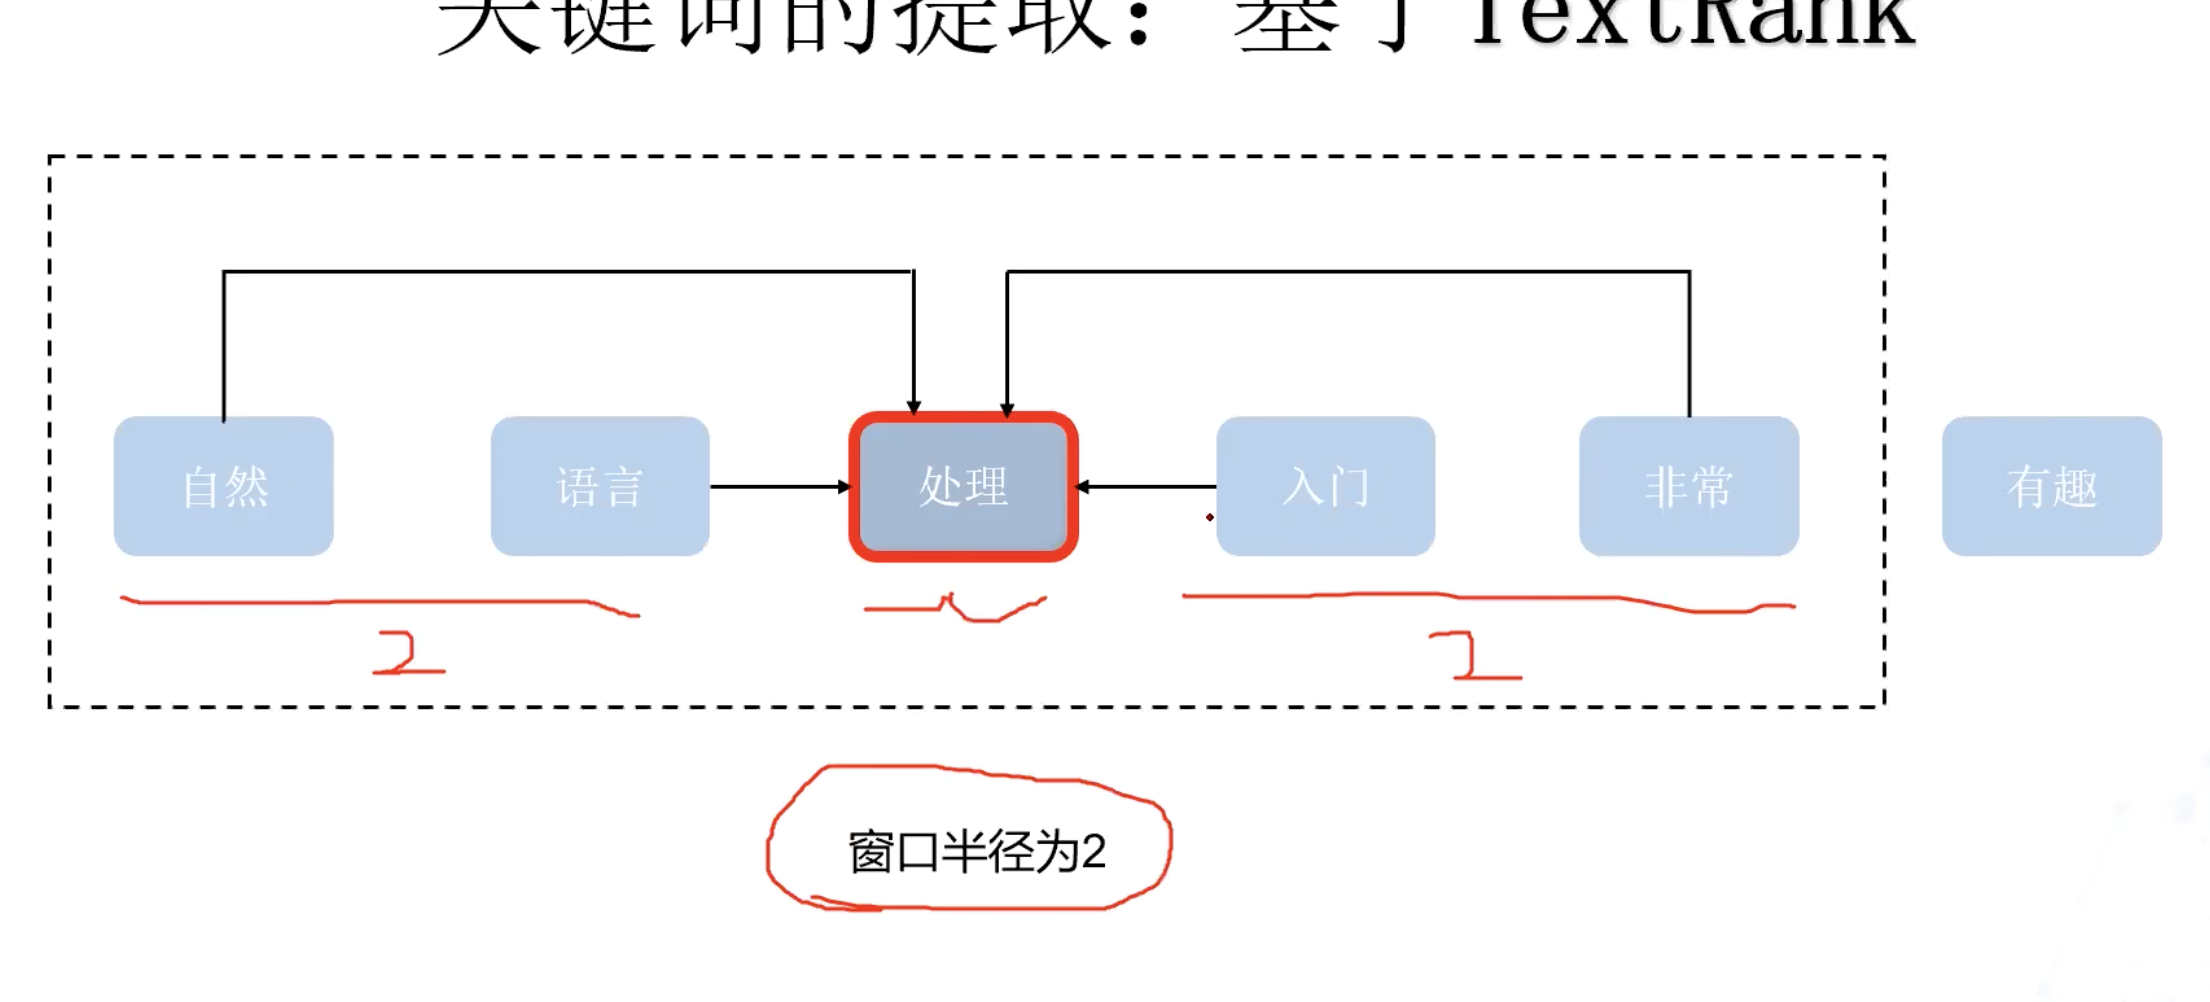
移动窗口位置,可以遍布所有的单词。
思考有什么可以改进的地方?
可能两个相邻的词关系并不会很紧密,而是与它有一定间隔的词有关系,比如我怎么打不开门这种的
可以从句法分析的角度来定义这种连接关系
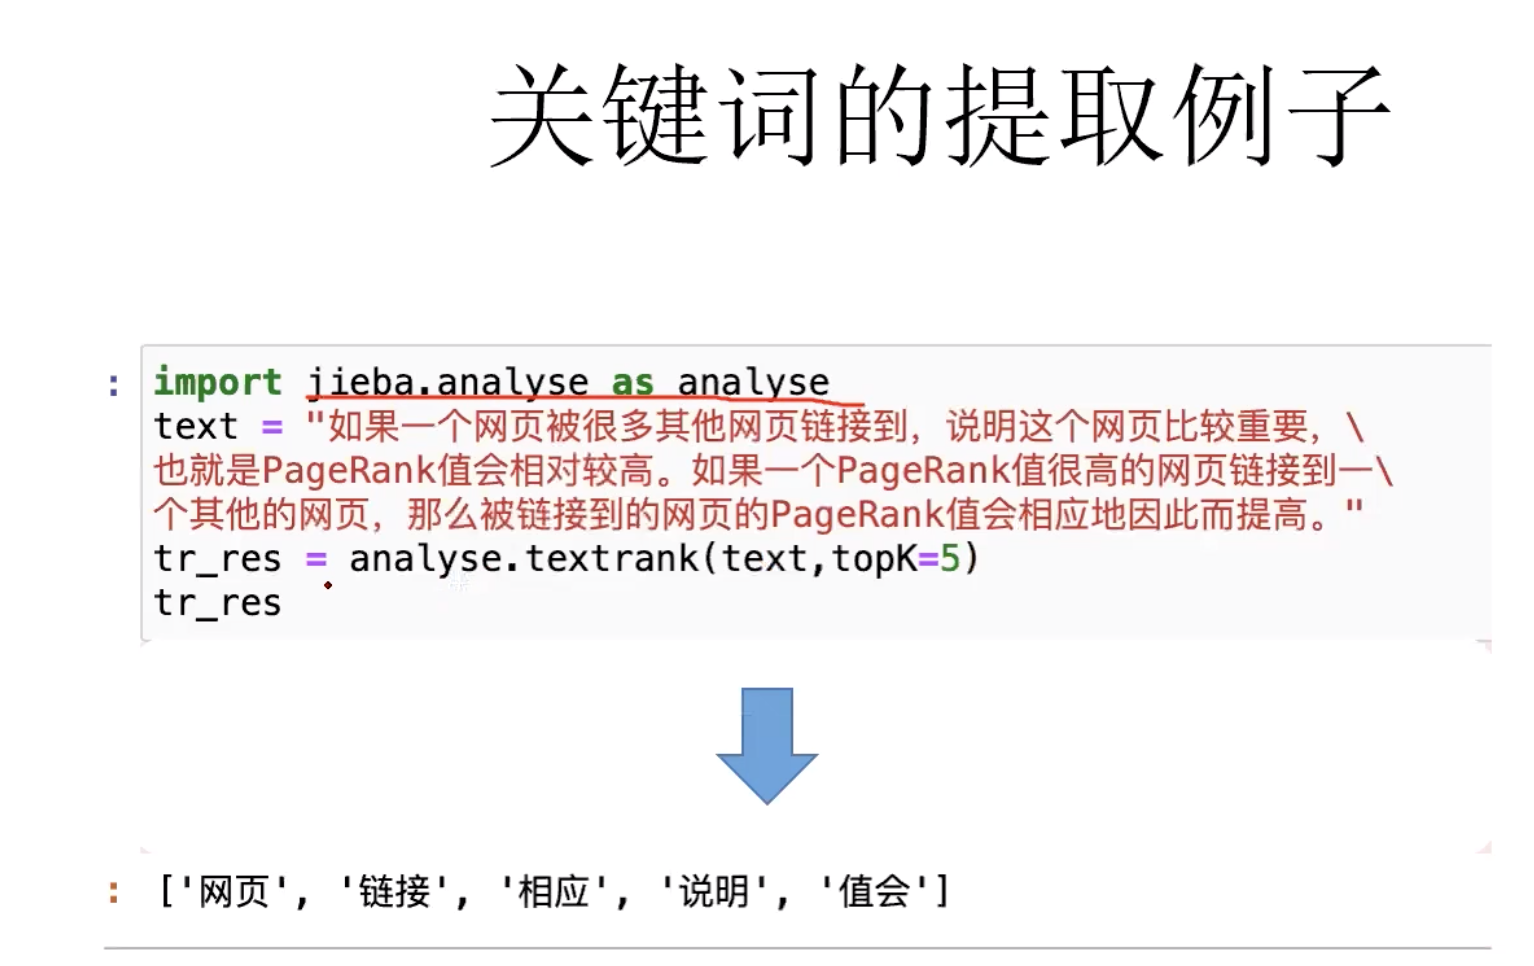
短语的提取
固定的词语搭配:十八般武艺,鲤鱼跃龙门
专业的表达:支持向量机,弱监督学习,自适应学习
新的短语:不明觉厉,5G元年,雨女无瓜
提取这些短语分为三个步骤:
- 基于N-gram统计获取出现频率比较高的短语作为候选项
- 对候选项进行多维度的特征统计
- 将多维度特征进行评估,排序,取TopK
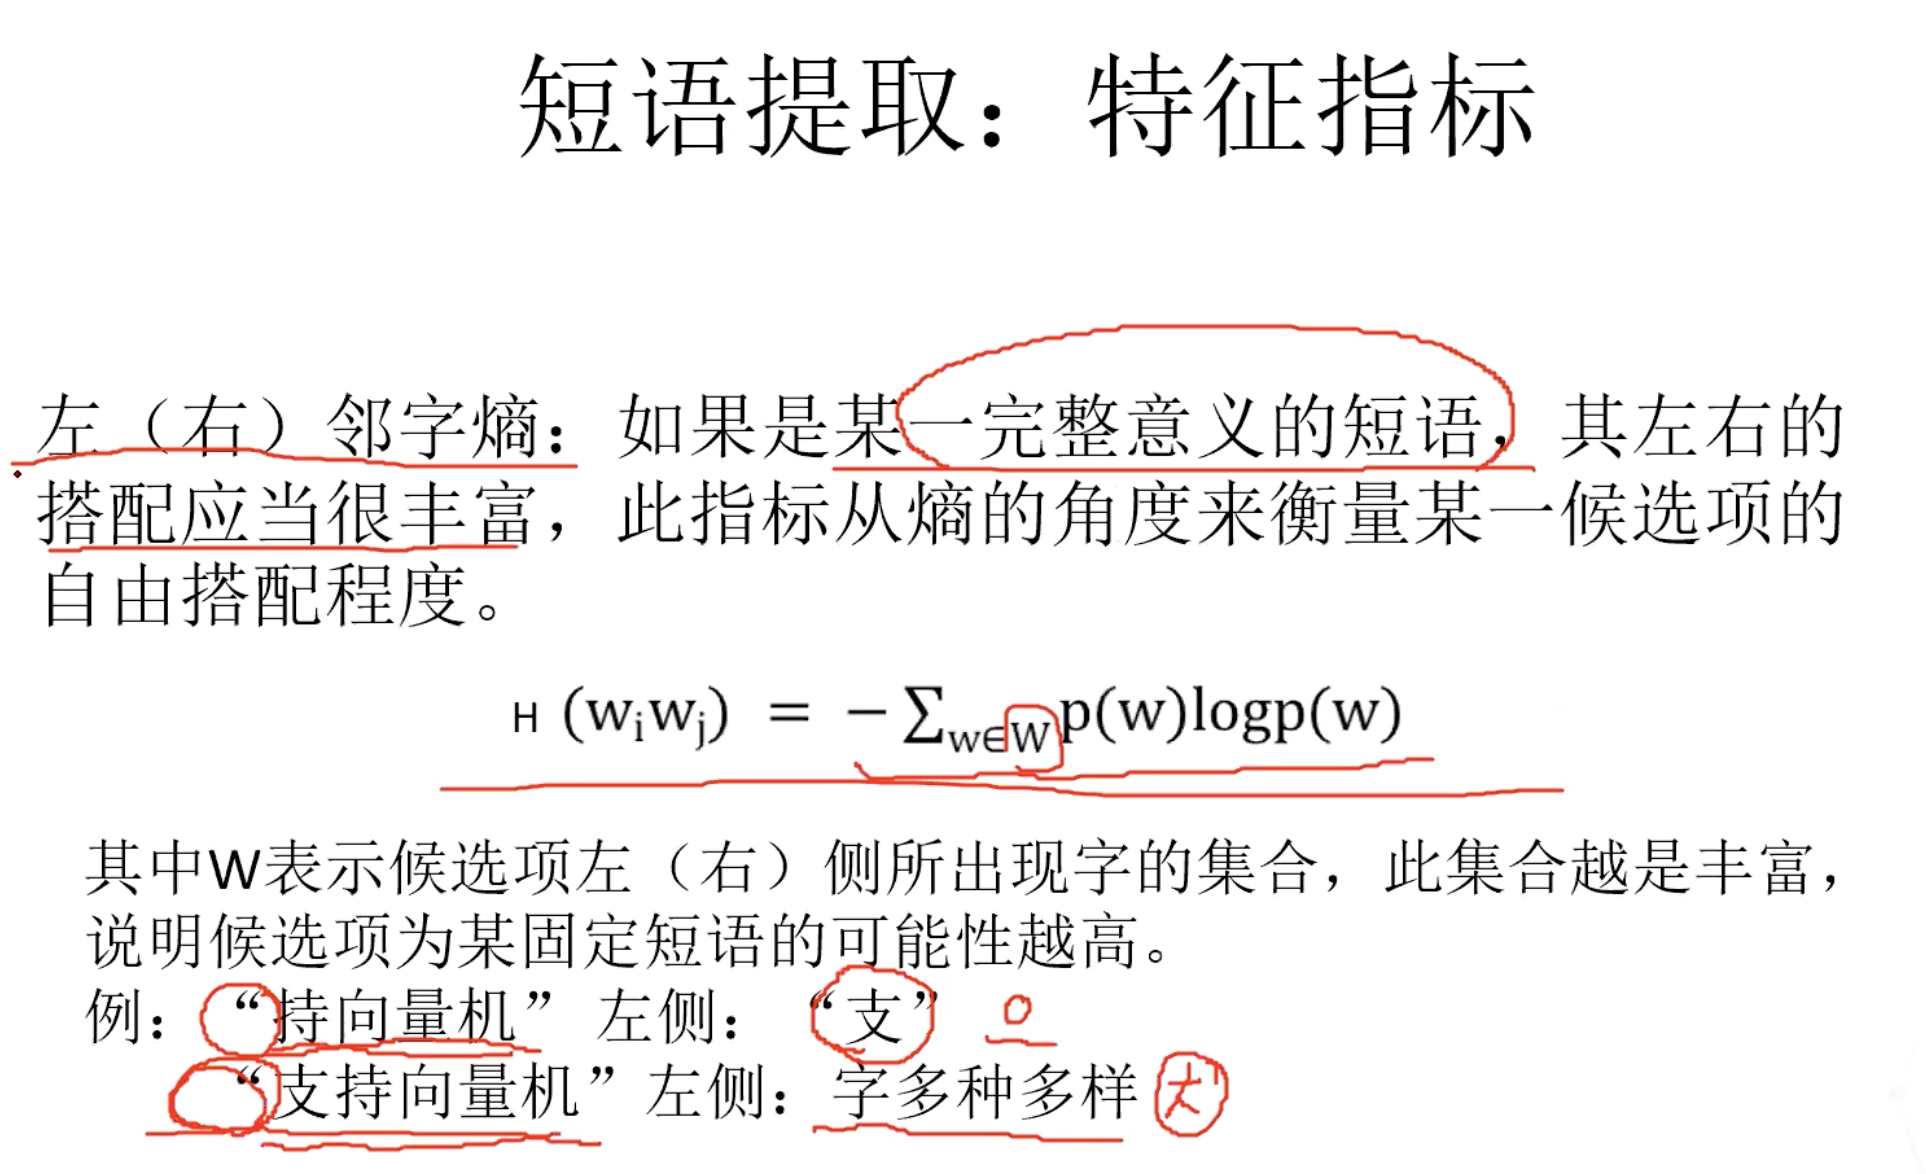
短语提取-特征指标
PMI(Pointwise Mutual Information):中文是点互信息,这个特征能够刻画单词间经常一起搭配的程度。
PMI(Wiwj)= log(P(wiwj)/p(wi)*p(wj))
如果两者联合出现的情况越多,单独出现的情况越少,PMI值就会越大,此候选项为某一固定搭配的的可能性就会越大。
这样会带来一个问题,比如:支持向量机 这个词,持向量机,这四个字也是满足上面这个条件的,我们应该如何避免呢?