文本处理技术-文本纠错
文本纠错技术
文本纠错又称为拼写错误或者拼写检查,一般存在两大纠错类型:
- Non-word 拼写错误
- Real-word 拼写错误
Non-word 拼写错误
表示词汇本身在词典中就不存在,比如要求写成了药求,correction写成了corrction
操作步骤分两步:
- 找到候选词
- 基于特定算法找出与错拼词关联最高的一个或者多个单词作为纠正选项
如何确定后选项呢?
英文:编辑距离
中文:拼写相近,字形相近(老年人用手写打字,或者有人用五笔打字)
如果找出了后选项,下一步就是找出最关联的项,根据贝叶斯定理,可以得到如下表达式:
P(侯选项|错误单词) 正比于 P(侯选项) * P(错误单词|候选项)
解释一下P(候选项)指的是此选项本身在预料中出现的可能性,P(错误单词|候选项)指的是人们意图打候选项会错打成错误单词的可能性
单纯只考虑候选项为一阶模型uni-gram,需要计算词语出现的频次,当然也可以扩展为二阶或者三阶,比如计算错误单词左边+候选项+错误单词右边在预料中出现的的情况。
Real-word纠错技术
单词本身没有错,但是不符合上下文的语境,常常涉及语义,语法层面的错误,比如我现在在公司里,错写成,我现在在公式里
操作步骤:
- 首先针对每个单词根据编辑距离,同音词,近形词等方式选出候选项(也包括单词本身)
- 接下来的计算基于候选项的语言模型,也要计算单词本身出现在语句中的概率,如果综合计算单词本身出现的概率比较大,则不进行纠正,否则推荐纠正项。
PS:如果我对所有的单词都进行排查,就会造成复杂度非常高,所以在实际应用中,不可能对所有的单词进行排查,而是首先应用语言模型等方式对句子进行粗粒度的初步筛查。
一般是给定一个句子,计算一下他出现的概率,如果不高,然后在进行筛查。
作业:文本纠错任务:Non-word英文纠错
作业提示:
- 找到候选项:使用编辑距离来找
- 语言模型,一阶或者二阶
- 条件概率模型:错词与正确的词的对应(无,认为他是1)
错误的思路:根据候选项去计算每一个词的出现的概率,这样复杂度会很高
正确的思路:根据候选项去生成编辑距离为1或者2的字符串,然后去匹配单词
低频次预处理:低频词
对于NLP的应用,我们通常会把出现频率很低的单词过滤掉
原因:
- 出现频率特别低的单词一般对分析作用不大
- 对于训练数据量影响不大
- 能够有效减少计算复杂度
上面出现的2,3两点是基于一个语言学现象叫做齐夫定律,这是由哈佛大学的语言学家齐夫所提出来的:
在自然语言的语料库里,一个单词出现的频率与他在频率表里面的排名成反比
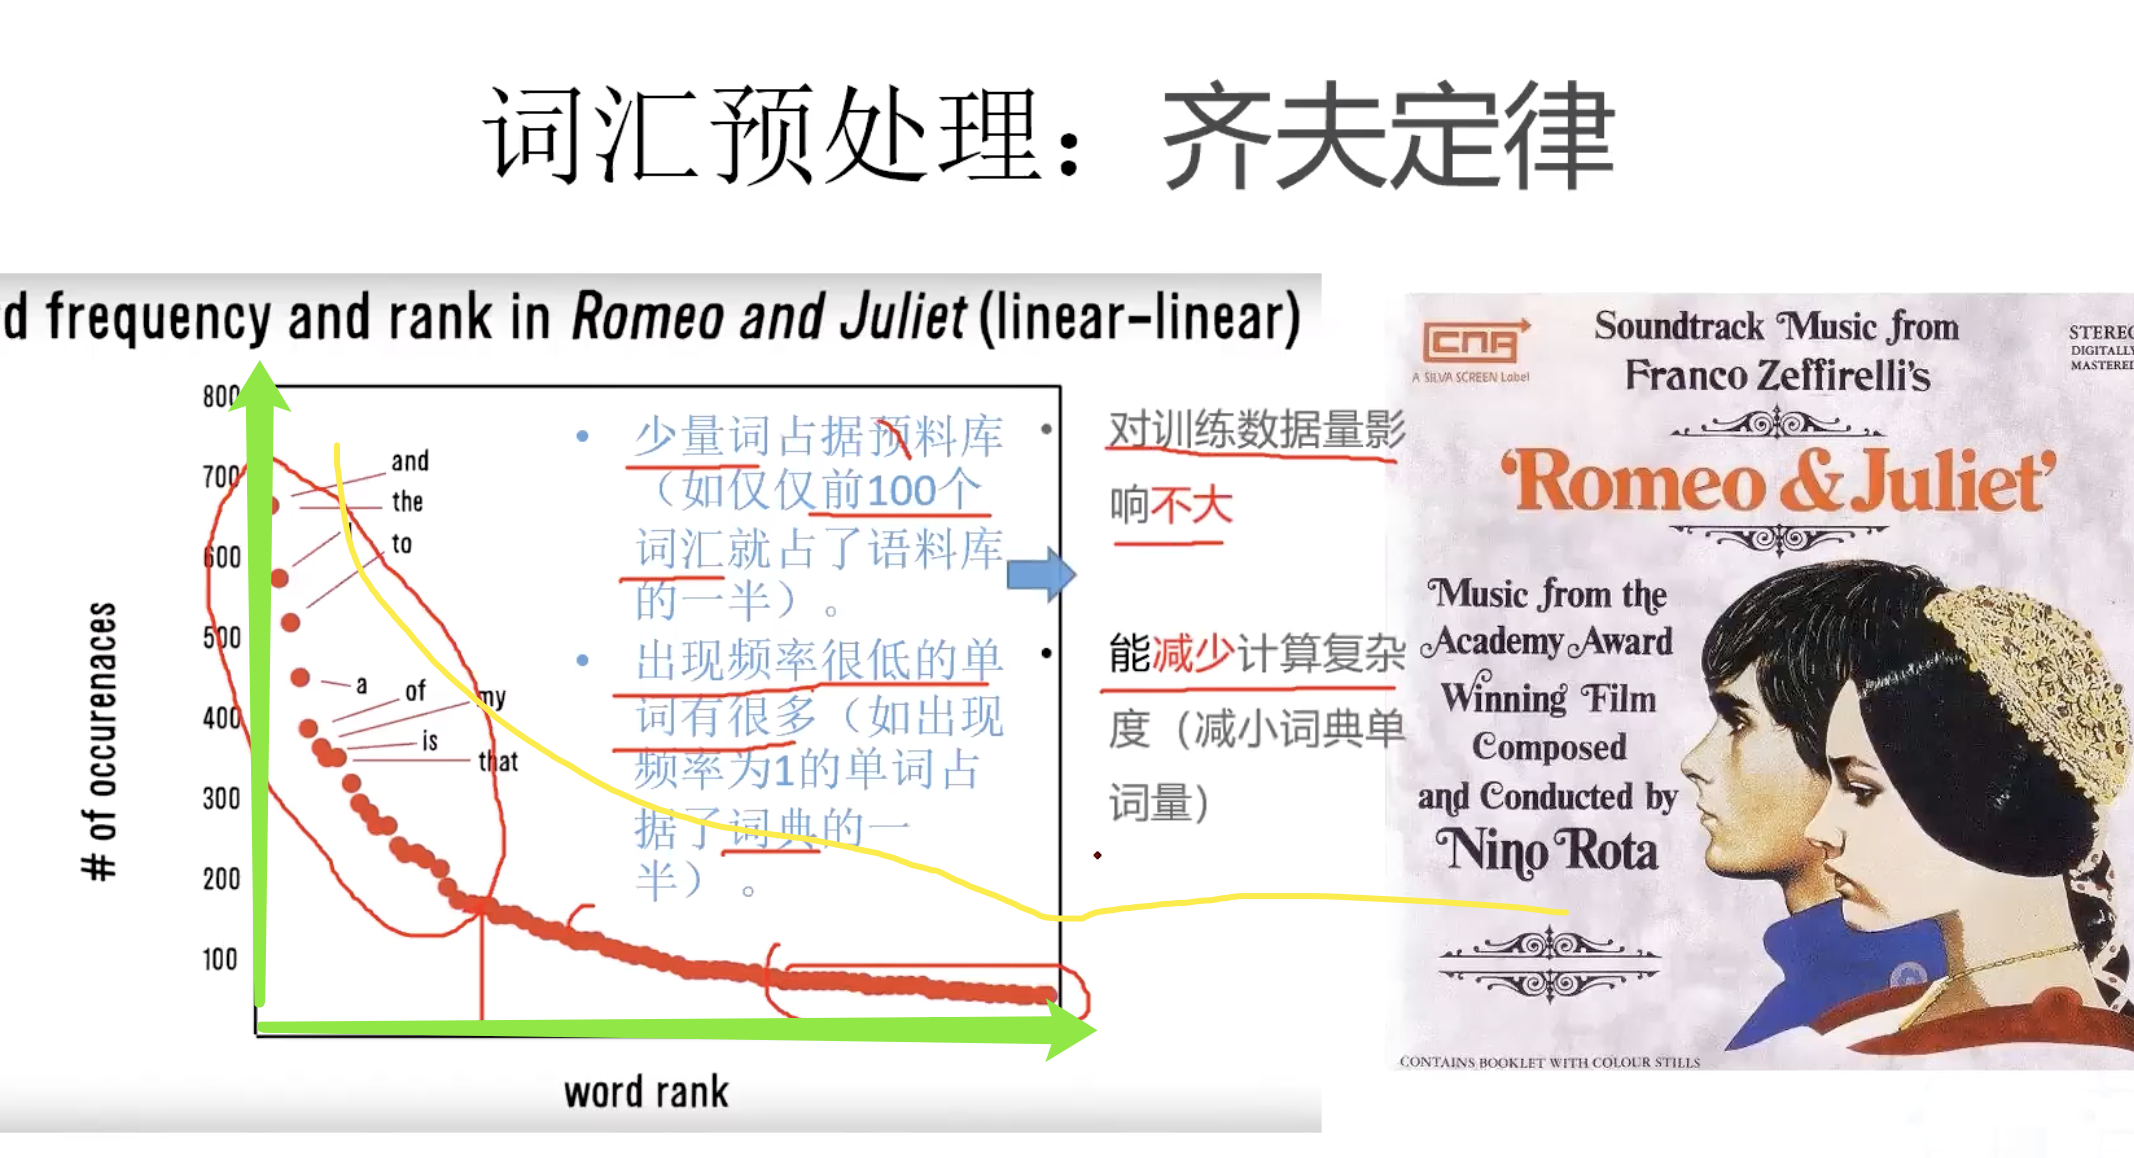
我的理解:低频词占据的词汇量多,去掉之后能够有效降低复杂度,另外低频词多但是数据量不大,去掉之后影响并不大。
齐夫定律又叫做长尾现象,越是普遍的出现频率越高,越是特殊的出现的频率越低。
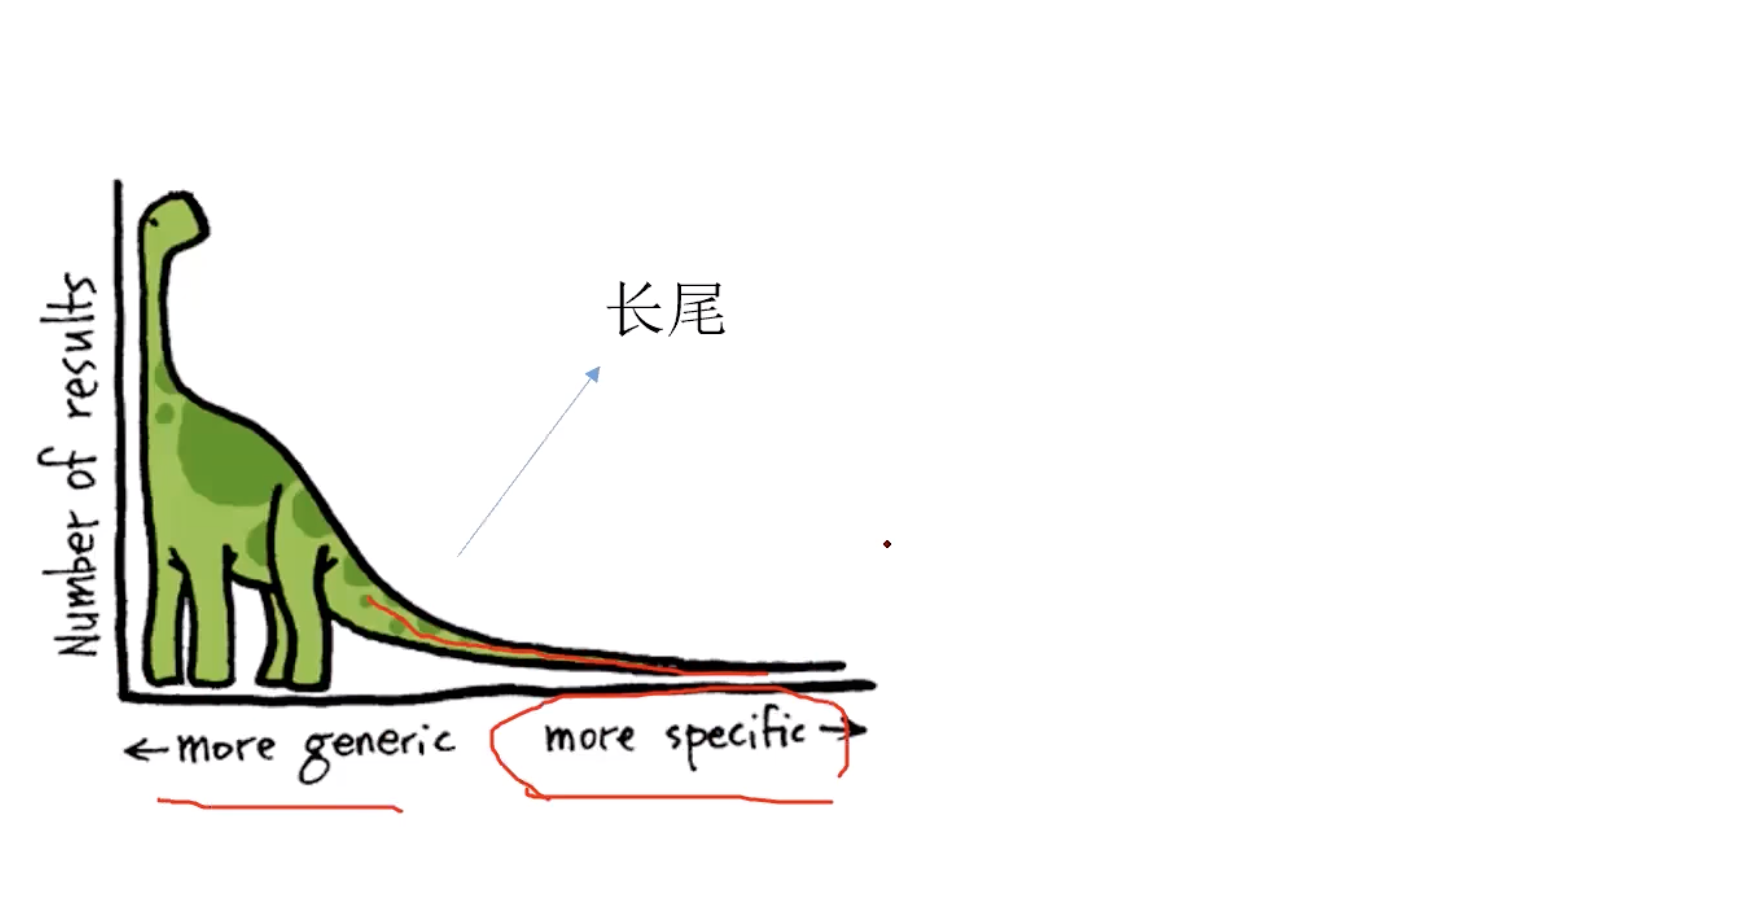
还有类似的二八定律。
停用词的预处理
语气词助词都可以做停用词来处理,但是具体的也要考虑到具体的应用场景